
AI写代码、解方程、编文献综述,现在连论文都能一气呵成——可真让它打开QuPath点几下鼠标分析一张肿瘤切片?在Mnova里调参数跑完一套核磁共振谱图解析?或者进ANSYS建模、网格划分、施加边界条件、跑完一场热力耦合仿真?别急着点头。清华团队刚甩出一份‘科研版驾照科目三’:OSWorld-Science,146道题,全是实验室里正在发生的活儿。
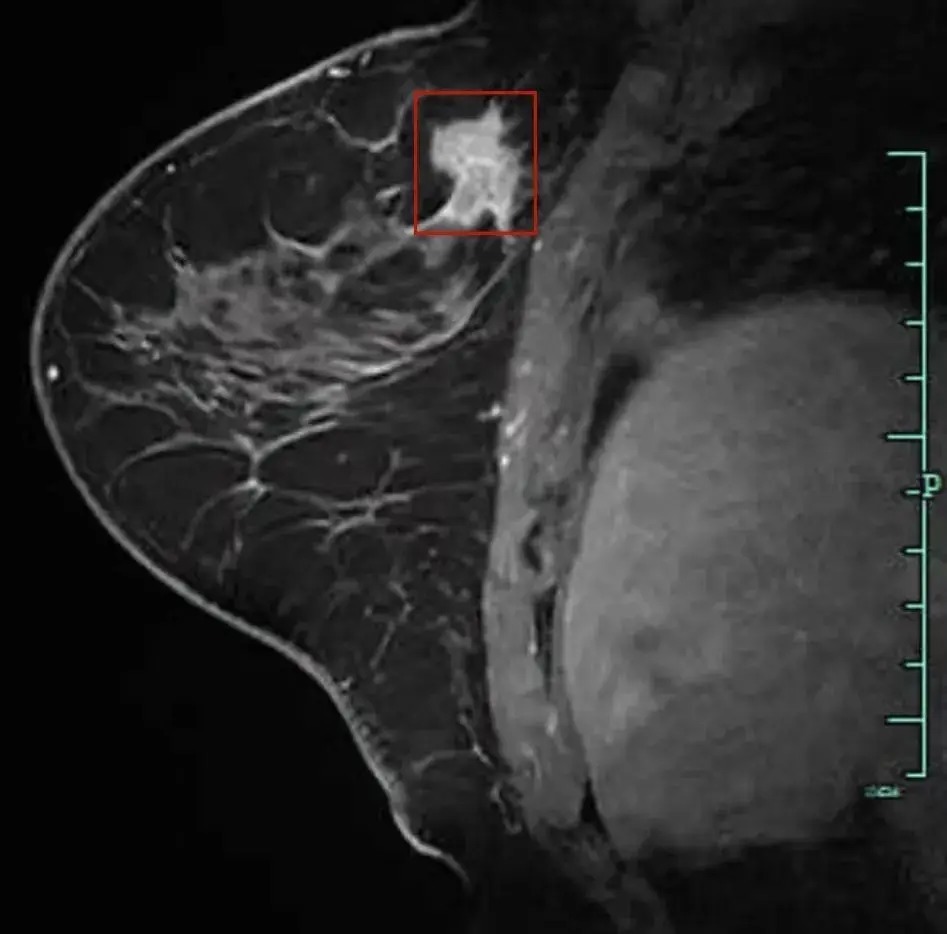
这可不是选择题。模型得在虚拟机里真操作——点菜单、拖文件、输命令、等进度条、查弹窗报错、回退重来……最后交出来的不是答案,是带时间戳的分析结果图、导出CSV、生成的.inp文件,甚至是一份能被导师直接放进论文补充材料里的PDF报告。12个当下最火的多模态大模型轮番上阵,平均只拿到34.3分。有人卡在导入DICOM文件时选错了序列,有人把ANSYS的求解器类型设成静力学却去算瞬态响应,还有人导出的病理计数表里,癌细胞数量比原始图像像素还多——系统当场判零分。
有意思的是,分数低,反而让人松了口气。它撕掉了‘AI已 ready for lab’的滤镜。科研不是解题,是闭环:问题→工具→操作→验证→复现。而当前AI缺的不是知识,是‘手’和‘手感’——对软件界面状态的即时感知、对失败反馈的容错调整、对领域惯例的隐性理解。就像教一个博士生用新软件,光讲原理没用,得陪他一起点错十次、看懂报错提示、翻三次帮助文档。OSWorld-Science不考聪明,考靠谱;不看它说得多好,只看它干得有多稳。
这事儿其实挺像当年实验室里刚来的小师弟——理论考试门门95+,结果第一次独立跑HPLC,把流动相比例输反了,基线直接飘出图谱外;或者用ImageJ数荧光强度,忘了关自动阈值,把背景噪声全算成阳性信号。导师没骂人,只是默默把原始数据发回来,附一句:“你点的这个‘Apply’,和你想让它干的事,不是一回事。”
OSWorld-Science里那些“低分瞬间”,恰恰是科研日常最真实的切片。比如在QuPath里做肿瘤浸润淋巴细胞(TILs)计数,AI会机械套用默认分类模型,却不知道病理共识里要求排除紧贴坏死区的CD8+细胞——这不是算法问题,是它没见过2019年《Journal for ImmunoTherapy of Cancer》那篇共识指南里的手绘示意图,也没听导师在组会上反复强调过“坏死边缘30μm内不计数”这条潜规则。
再比如Mnova解析核磁时,人类老手看到某个峰分裂异常,第一反应是查溶剂峰残留、看匀场曲线、翻样品离心记录;AI却可能直接拟合出一个数学上完美但化学上荒谬的耦合常数。它没经历过师兄熬夜调匀场后突然发现氘代试剂快用完了的抓狂,也没体会过导师指着谱图说“这个峰太干净,不像活细胞提取物”的直觉判断。
更现实的是工具链的“毛边感”:ANSYS里一个边界条件选错,仿真结果偏差500%,但软件不会弹窗警告“您正在违背热力学第二定律”,只会安静跑完,输出一份看起来很专业的.inp文件。这种沉默的容错空间,恰恰是人类经验最擅长填的坑——而AI现在连“坑在哪”都得靠试错撞出来。
所以清华这份考卷的价值,不在打分,而在定调:科研自动化真正的门槛,从来不是“会不会”,而是“懂不懂什么时候不该那么干”。当AI终于能稳稳点开QuPath、拖进DICOM、手动勾选ROI、导出带单位的CSV、再顺手把图表配色改成Nature期刊推荐的色盲友好方案——那它才算真正拿到了实验室工牌,而不是一张停留在PPT里的“未来员工入职通知书”。
说到底,科学不是炫技的舞台,是笨功夫堆出来的可信。而可信,得从一次没跳过的报错提示开始。
永信证券提示:文章来自网络,不代表本站观点。