
先问你一个问题。
如果你要教一个机器人叠毛巾,你会怎么教?大概率是让它看无数遍人叠毛巾的视频,然后模仿动作。这是现在机器人学习的主流思路,叫做模仿学习。但这里有个隐藏的漏洞:机器人学会了"看到毛巾就折"这个动作,却不一定理解"折毛巾"这件事背后的物理逻辑,比如布料会怎么变形、力气该用多大。
这就好比一个孩子背下了"1+1=2",却不明白加法到底是什么意思。一旦题目稍微变一下,比如换成"1+2",他就懵了。
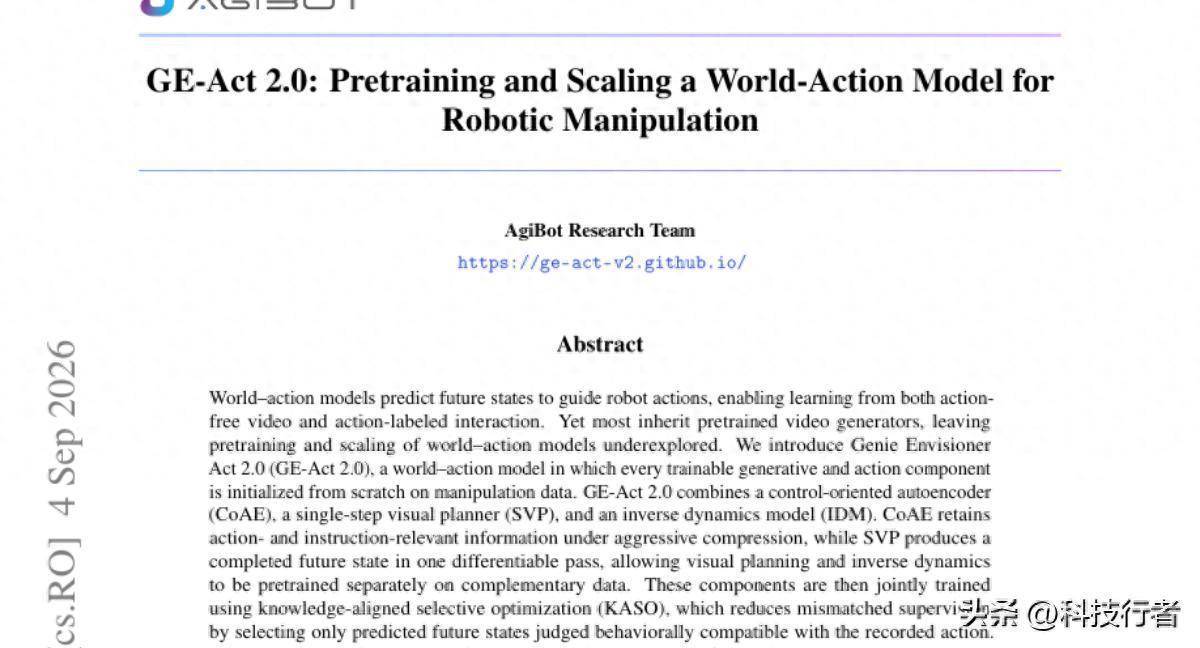
这正是AgiBot研究团队在这篇论文里想解决的问题。他们提出了一个叫GE-Act 2.0的系统,全称Genie Envisioner Act 2.0,试图让机器人不仅会"做动作",还能先在脑子里"预演"一下将来会发生什么,再据此决定怎么动手。这类系统有个专门的名字:
世界-动作模型(World-Action Model, WAM):一种先预测场景会如何演变,再根据这个预测来生成动作的机器人学习范式。它和传统的"看图做动作"不同,多了一步"预见未来"的环节。
核心问题:大家都在借用别人的眼睛
这里有个挺反直觉的事实。
你可能以为,既然世界-动作模型这么厉害,那做这类研究的团队肯定都是从头训练一套完整系统。但事实并非如此,几乎所有现有的世界-动作模型,都是拿别人训练好的视频生成器来"改装"的,比如NVIDIA的Cosmos或者阿里的Wan。这些视频生成器原本是为了生成好看的、逼真的视频而设计的,压根不是为了给机器人做决策服务的。
这就好比你想造一辆赛车,但没有自己设计发动机,而是直接把一辆家用轿车的发动机拆下来装上去。它能跑,但跑不快,因为发动机的设计初衷就不是为了赛道。
这种"拿来主义"带来了两个实实在在的麻烦。
第一个麻烦是效率问题。这些通用视频生成器为了保证画质,压缩率做得很保守,通常只把画面空间维度压缩8倍或16倍,这意味着每一帧图像被编码后还是一大堆数据(专业说法叫"token
永信证券提示:文章来自网络,不代表本站观点。